Cuentan quienes saben de aceite que el verdadero peligro de una almazara moderna no es que se rompa la gigantesca centrifugadora de acero inoxidable, sino que el maestro de almazara pierda el olfato. A fin de cuentas, embotellar aceite malo cuesta exactamente los mismos vatios que embotellar ambrosía. Sin un buen criterio que le ponga control, la automatización podría terminar optimizando las cosas equivocadas.
No es un tema que podamos bautizar como nuevo. Al contrario, es el tema estrella en estos tiempos de incertidumbre: ¿dónde centrar nuestros esfuerzos cuando la inteligencia artificial automatice mi trabajo diario? En tono existencialista, ¿de qué vamos a trabajar cuando la inteligencia artificial automatice nuestro trabajo actual?
Pero vamos a mantener la calma. El mediático apocalipsis de trabajo no parece estar avalado por datos (más bien al contrario, Economist incluso habla de un boom de trabajos nuevos) y de la revolución industrial aprendimos que la transición fue generacional, quienes ya eran artesanos tenían un saber hacer que siguió siendo valioso durante décadas, incluso cuando las nuevas generaciones entraron al mercado laboral con nuevos roles adaptados a las nuevas máquinas disponibles.
De esto hemos hablado ya en varias ocasiones (¿De verdad los LLM nos van a volver estúpidos?), pero creo que el análisis más detallado lo hice a puerta cerrada en una newsletter interna para mis compañeros de trabajo, de modo que voy a traerme aquí algunas de las ideas que escribí entonces, acerca de qué tipo de tareas tiene sentido automatizar y en qué tipo de tareas tiene sentido enfocarnos nosotros.
Para ello, vamos a evaluar las tareas desde dos puntos de vista, cada uno con un pequeño marco analítico de respaldo:
- Sobre tareas propiamente dichas, ¿dónde tiene más sentido enfocarte si eres una persona?
- Sobre productos (o funcionalidades de producto), ¿qué tiene sentido internalizar y qué delegar en LLMs?
Mapeando tareas en el doble eje que va de la automatización fácil a la validación difícil
Hace unos meses se publicó un artículo muy cuco en este aspecto: Some Simple Economics of AGI (Arxiv). Oh sí, AGI. Ahora todo es AGI, y cuando todo es AGI nada es AGI. Algo manoseado el término. Pero vamos a no derrapar y continuemos con el artículo.
En este paper Catalini, Hui, y Wu clasifican tareas atendiendo a 2 ejes sencillos: cómo de sencilla o difícil es una tarea de automatizar y cómo de sencilla o difícil es de validar.
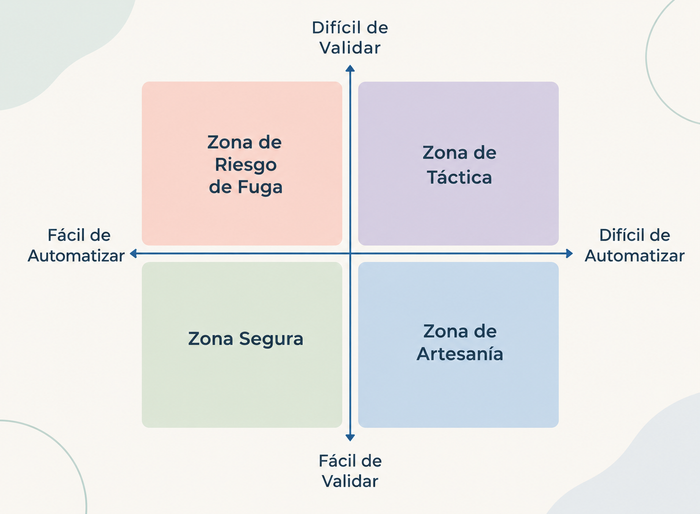
Esos dos ejes permiten establecer cuatro cuadrantes en los que clasificar nuestras tareas:
- Fácil de automatizar / Fácil de validar
Esta es terreno para la máquina, con seguridad. Aquí se encuentran muchos casos de uso exitosos, sobre todo en ingeniería. El desarrollo de software es un buen ejemplo: el software puede generarse rápidamente y validarse de forma fiable a bajo coste; o bien compila y cumple con los criterios de rendimiento, o no lo hace. No hay trampas ocultas. - Difícil de automatizar / Fácil de validar
Zona de artesanía. Muchas actividades físicas o especializadas se sitúan aquí. Siguen siendo difíciles de automatizar, pero relativamente fáciles de evaluar una vez completadas. Fontaneros, electricistas, albañiles. El tubo pierde agua o no lo pierde, fácil de ver. - Difícil de automatizar / Difícil de validar
Se trata de actividades profundamente humanas y de carácter tácito, en las que tanto la automatización como la validación representan un desafío. Los ámbitos político y religioso están en esta categoría. Aunque seguro que hay quien sugiere que para el tipo de perfil humano que entra en política, quizá mejor un algoritmo… No entro a juzgar. No parece que la IA vaya a permitir automatizar esos asuntos a corto plazo. - Fácil de automatizar / Difícil de validar
Este es el cuadrante de mayor riesgo, donde una fuga genera problemas que tardamos mucho en notar de modo que sus efectos son siempre graves. La automatización resulta tentadora por ser económica y rápida, pero la validación es lenta, costosa o tardía. La calidad de algunas decisiones solo se revela con el paso del tiempo (pensemos, por ejemplo, en las inversiones, que son casi siempre planes de ejecución medio, largo, o muy largo plazo). Cuando la validación se demora respecto a la ejecución, el riesgo se acumula en el tiempo. En tiempos de ejecución automática ese diferencial puede ser enorme. Y cuando explote será devastador.
Conceptos conocidos para quienes siguen mis artículos como el de brecha de supervisión están relacionados con algunas ideas de ese artículo. El foco en la definición y la validación también.
Pero vamos con el segundo marco: el de producto. La misma lógica que decide dónde has de poner tu esfuerzo como persona va a ayudarnos a entender dónde poner nuestro esfuerzo al pensar en términos de producto.
La escasa primavera de un producto atrapado entre la promesa del verano y el frío del invierno
Todo lo anterior describe qué tipo de tareas tiene más o menos sentido automatizar pero, ¿qué sucede si eres una empresa que quiere sobrevivir en el mercado con un humilde producto que resuelva un problema concreto? ¿En qué aspectos tiene sentido invertir esfuerzo para añadir valor diferencial y qué otros aspectos conviene directamente delegar?
Discrepo de quienes dicen que el software ha muerto. El software lleva décadas transformando nuestro mundo y ahora producirlo es más barato que nunca. ¿Muerto? Vamos a producir más software del que jamás habíamos soñado. Solo que va a ser diferente. La promesa del viejo software-como-servicio (SaaS) está en horas bajas. Va a haber muchísimo más software, pero adaptado a flujos y problemas concretos (personales o corporativos).
Así que hablemos de software como producto. Hay quien defiende que conviene programar esa capa que habla con el modelo, el harness. Prácticamente todas las startups de IA que vemos se dedican a eso de una forma u otra: un software que interroga modelos, incluso las que hacen cacharritos a los que das órdenes de voz están, en esencia, dándote un harness para hablar con un modelo.
El asunto es que esto va muy rápido y se mueven dos frentes a la vez. En este último año hemos visto cómo los modelos se liaban cuando se les llenaba la ventana de contexto, cómo aprendían a anotar lo que sabían que iban a necesitar más adelante para no perderlo al seguir rodando esa ventana, y luego empezaron a trocear proyectos largos que no cabían en su ventana. Todo esto estaba primero en los agentes (el harness) y luego en los modelos mismos. Anthropic ya contó en su blog como al mejorar los modelos, piezas completas del agente/harness dejaron de ser necesarias. Opus incorpora ahora lógica que inicialmente estaba en Claude. El modelo aprende del harness y este último se adelgaza, haciendo hueco para terraformar nuevas habilidades que, al tiempo, serán aprendidas por el modelo y traspasadas al mismo.
Así que ya no es solo el miedo a que OpenAI, o Anthropic, o Google, vean tu ingeniosa idea de producto y decidan incorporarla a su producto, con mil veces mejor distribución que el tuyo. Es que los propios LLM con los que tu producto interactúa la terminen aprendiendo y la hagan sin que el harness de los grandes vendors de IA la incorpore.
La situación recuerda a la de la Web 2.0 a principios de siglo, cuando el mayor objetivo era que te comprasen Google o Microsoft y tu mayor miedo era… que decidiesen implementar tu idea sin comprarte.
La prueba de PACO, o prueba de absorción
En estas encontré en un post en Hackernoon una taxonomía interesante para decidir qué parte de tu producto es core y te toca hacerlo y qué parte vas a delegar en otros. La pregunta que se hace es: ¿cómo identifico si merece la pena poner a mi equipo a programar una cierta funcionalidad? Para responderla usa otras dos preguntas:
- ¿Podría uno de los laboratorios en la frontera lanzar tu producto como funcionalidad base de su propio harness?
- ¿Podría un modelo aprender tu lógica de negocio y resolverla automáticamente volviéndote innecesario?
Si la respuesta a alguna de estas dos es positiva, es muy probable que no te merezca la pena invertir horas de ingeniería en ese aspecto concreto, porque antes o después te van a absorber o el LLM o alguno de los grandes laboratorios de IA con sus clientes de uso masivo.
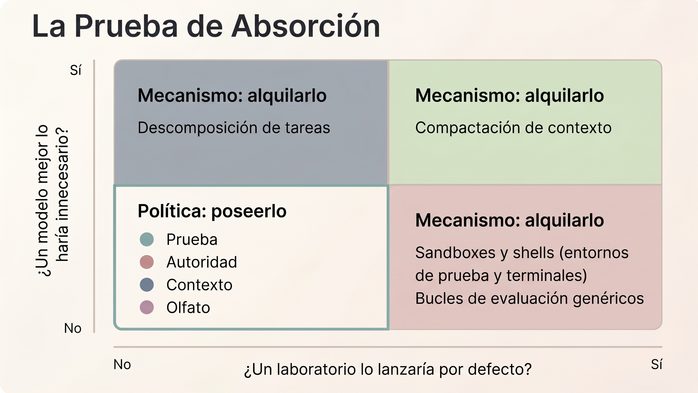
Con esta habilidad tan norteamericana para los acrónimos, el artículo propone PACT (Proof, Authority, Context, Taste) para guiarnos. A mí al traducirlo me ha salido PACO porque taste lo he traducido como olfato, no solo por las risas sino porque frente a la solemnidad de Silicon Valley quizá viene bien una chispa de sentido común.
Básicamente, hay que huir de los mecanismos, cuyo acceso va a generalizarse y enfocarse en las reglas de juego que definen qué puede hacerse con los mecanismos.
- Prueba. Validación funcional. Los agentes son indulgentes evaluándose a sí mismos y tienden a inflar su propia nota. A mayor volumen de trabajo generado, más cotiza la capacidad de auditarlo.
- Autoridad. Gobernanza y accesos. Quién actúa, qué permisos tiene y hasta dónde entra la IA. La plataforma te da la infraestructura; el límite de actuación no se delega.
- Contexto. La verdad interna del negocio. Tus procesos, fuentes y convenciones de código. Ningún modelo preentrenado conoce tu organización, así que esta memoria es cosa tuya.
- Olfato. El listón de calidad. Sin control, los LLM convergen en lo genérico. Abandonar esa mediocridad exige forzar al modelo a ir por el camino que tú le trazas, programar tu propio estándar en el sistema que lo va a controlar.
Si la funcionalidad pasa la prueba de PACO y gestiona aspectos de la validación, la gobernanza, el contexto único del problema a resolver, o el criterio que ha de definir qué es bueno, entonces merece la pena meterla al backlog y programarla de forma nativa. Así que ya saben, si estaban pensando en hacer un microagente especializado en extraer información de charlas TED, no pasa la prueba de PACO, cualquier modelo lo hace ya sin más. Pero si piensan ayudar a los contables a cerrar el trimestre fiscal validando contra normativas específicas y usando contexto interno de empresas no disponible en otro sitio, quizá tenga sentido ayudarles a tener un harness o un software específico (al menos, por ahora).
La convergencia de ambos enfoques
Ambos marcos convergen en el criterio como valor clave, quizá lo único que sigue humanizando en este bucle. La validación difícil del primer marco y el olfato del segundo son la misma cosa vista desde dos ángulos: el criterio que decide si el aceite es bueno. Por ahora, ése sigue siendo nuestro lugar en el bucle. Parece que a nuestro maestro de almazara no va a ser fácil reemplazarlo.
